NEOPOLIS AKADEMY
AI Data Engineering and RAG Practitioner
Concevez pipelines de données robustes pour RAG : ingestion, parsing, découpage en chunks, calcul d’embeddings, recherche vectorielle et hybride, contrôle d’accès, gestion des citations et stratégies de rafraîchissement des données.
Découvrir cette formation sur Akademy ↗Les inscriptions et les modalités pratiques sont disponibles sur Neopolis Akademy.
Ce que vous allez découvrir
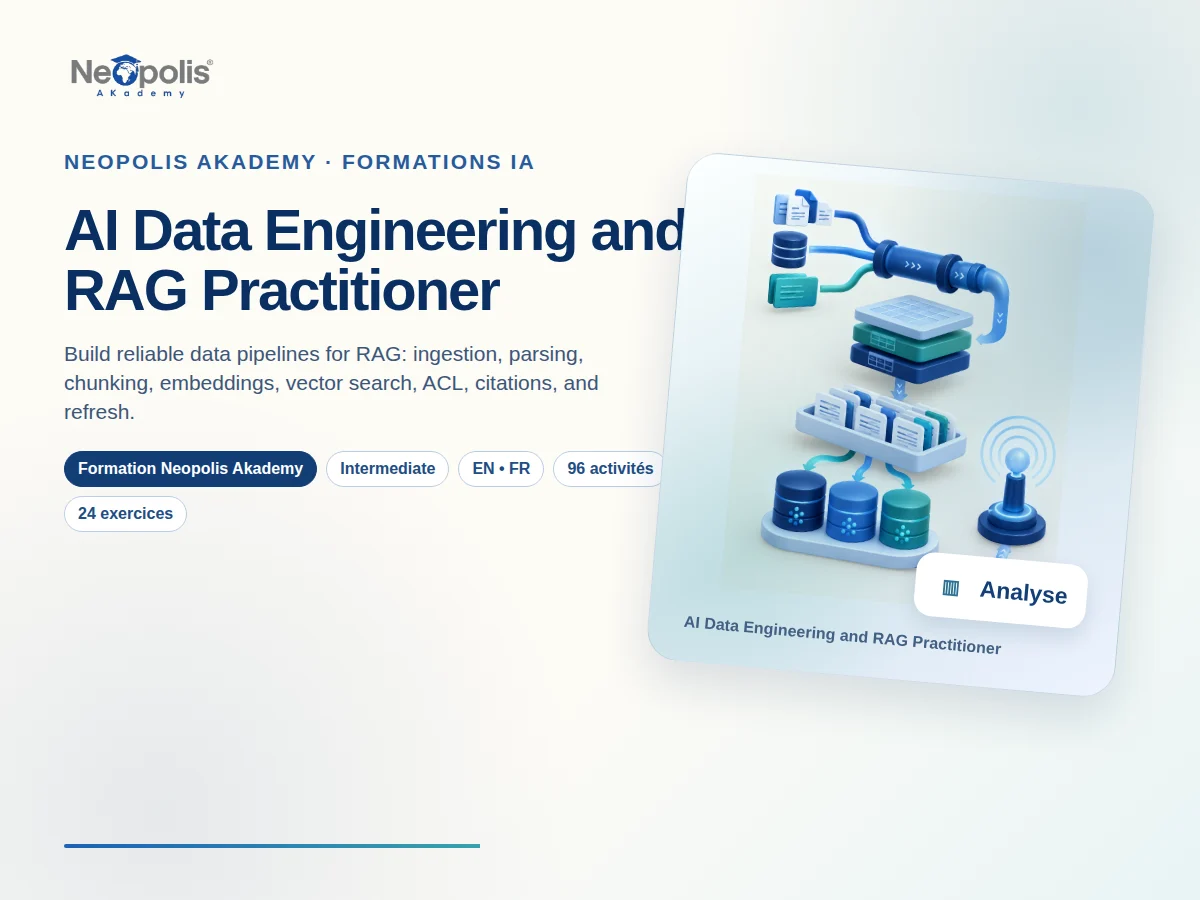
Cette formation intermédiaire couvre la préparation des sources pour RAG, depuis l’ingestion jusqu’au stockage indexé.
Elle détaille les méthodes de chunking et de choix des embeddings pour maximiser la pertinence en recherche vectorielle.
Vous verrez l’implémentation de recherches vectorielles et hybrides, et comment combiner signaux sémantiques et booléens.
Le programme aborde aussi la gestion des citations, des règles d’accès (ACL) et des stratégies de mise à jour pour garder les données fraîches.
PAS À PAS
Le programme de la formation
01RAG Data Foundations
Bases du RAG pour ingénieurs de données IA : architecture, limites et gestion des sources. Couvre inventaire des sources, propriété des données, fraîcheur, ACL, et formats courants (PDF, HTML, Markdown, CSV) ainsi que design des métadonnées pour citations et filtrage.
Explique l’architecture RAG, les scénarios où éviter RAG et les points centraux à considérer (concepts clés et enseignements).
Détaille l’inventaire des sources, la propriété des données, la gestion de la fraîcheur et les règles d’accès (ACL) pour alimenter un pipeline RAG fiable.
Présente les techniques pratiques de parsing pour PDF, HTML, Markdown, CSV et enregistrements structurés, avec les implications pour l’indexation.
Propose des principes de conception de métadonnées permettant d’assurer citations précises et filtrage efficace lors de requêtes RAG.
Voir ce module sur Akademy ↗02Chunking and Embeddings
Techniques de découpage et d’embeddings : stratégies de chunking (fixe, sémantique, récursif, aware document), choix de modèles d’embeddings multilingues, déduplication, normalisation et indexation incrémentale.
Compare stratégies de chunking adaptées aux pipelines RAG et explique avantages/inconvénients selon structure documentaire.
Présente critères de sélection des modèles d’embeddings et enjeux multilingues pour des recherches vectorielles robustes.
Décrit méthodes de déduplication, normalisation et hachage de contenu pour éviter redondances et incohérences dans l’index.
Explique l’indexation incrémentale et les déclencheurs de ré-index pour maintenir la pertinence des données sans reposer l’intégralité du corpus.
Voir ce module sur Akademy ↗03Vector and Hybrid Search
Recherche vectorielle et hybride : notions (cosine, dot product, HNSW, IVF), usage de pgvector pour déploiements petits/moyens, Qdrant pour recherche dédiée avec filtrage payload, et stratégies hybrides BM25+vector+reranking.
Présente principes de recherche vectorielle (mesures de similarité, indexapprox comme HNSW/IVF) et conséquences sur latence/qualité.
Explique l’intégration de pgvector dans Postgres comme solution pratique pour RAG de petite à moyenne taille.
Décrit Qdrant comme moteur dédié, incluant filtrage par payload et scénarios d’utilisation adaptés.
Expose les architectures hybrides combinant BM25, recherche vectorielle et étapes de reranking pour améliorer précision et couverture.
Voir ce module sur Akademy ↗04Grounded Answers and Citations
Réponses fondées et citations : modèles de templates de prompts pour réponses ancrées, UX d’attribution des sources, contrôle d’accès au niveau document et opérations de production (refresh, jobs, monitoring, rollback).
Décrit templates de prompts visant à produire réponses ancrées sur des passages récupérés et bonnes pratiques associées.
Aborde l’UX d’affichage des citations et l’attribution des sources pour garder la traçabilité des réponses générées.
Précise mécanismes de contrôle d’accès et permissions au niveau document pour respecter règles d’accès et confidentialité.
Couvre aspects opérationnels en production : rafraîchissement des données, jobs d’indexation, monitoring des pipelines et stratégies de rollback.
Voir ce module sur Akademy ↗Source du programme : Neopolis Akademy. Fiche d’origine